

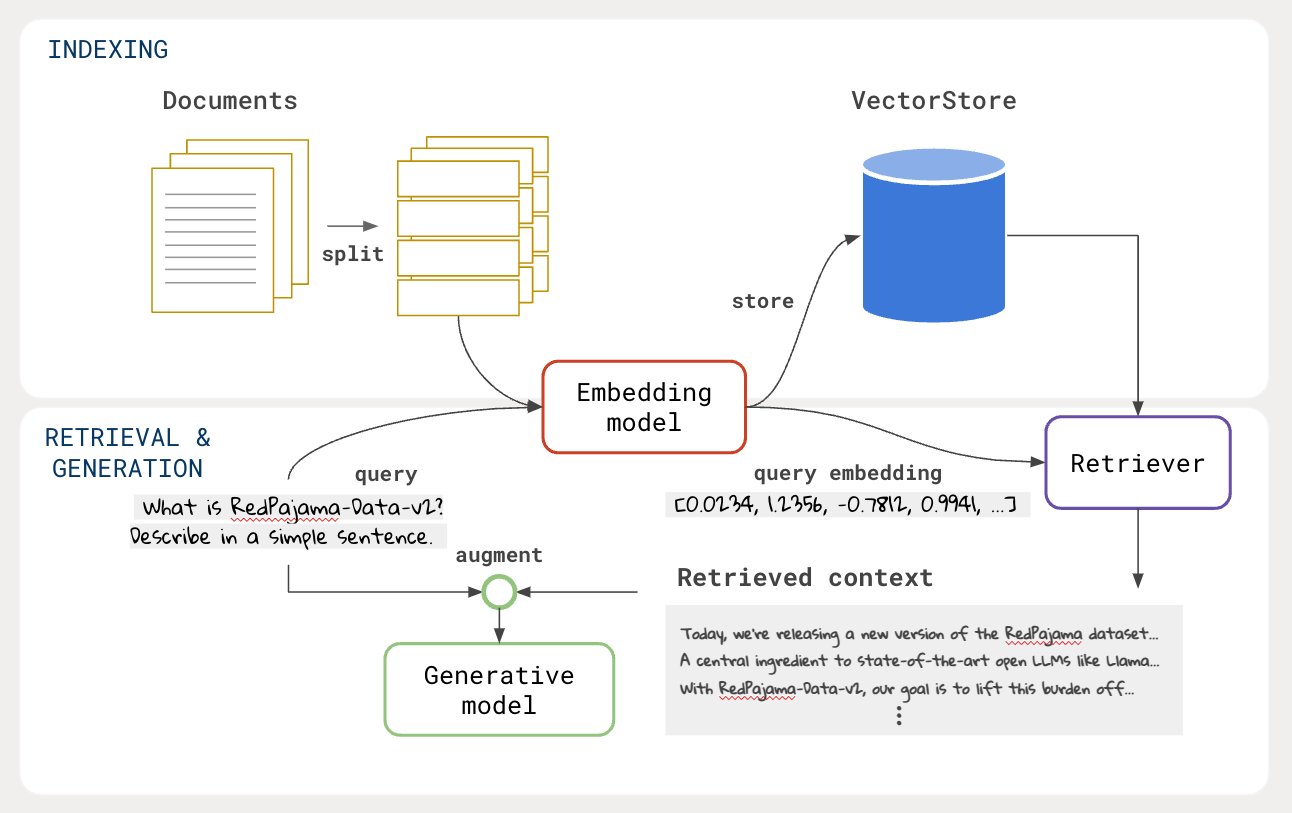
Alur Eksekusi Cepat
Embeddings Capability
Spesifikasi parameter endpoint /v1/embeddings dan format output vektor.
Katalog Model Embedding
Daftar model embedding yang tersedia seperti nusa-embedding-0001 dan nv-embed-v1.
Implementasi Step-by-Step
1
Instalasi Dependensi
2
Definisikan Embedding Function Kustom
ChromaDB mendukung custom embedding function untuk menghubungkan panggilan embedding ke endpoint
/v1/embeddings Neosantara:3
Indeks Dokumen ke Koleksi Chroma
Simpan sekumpulan dokumen ke dalam koleksi ChromaDB. Koleksi akan otomatis memanggil fungsi embedding Neosantara untuk menghasilkan vektor 768 dimensi:
4
Pencarian Vektor & Grounded Generation
Cari bagian yang paling relevan dengan kueri pengguna menggunakan pencarian kemiripan kosinus, lalu minta model chat menghasilkan jawaban yang didasari konteks tersebut:
Kode Lengkap & Pengujian
Berikut skrip lengkap yang menguji pertanyaan yang ada di dalam dokumen maupun pertanyaan di luar basis pengetahuan:rag_chroma_complete.py
Model
nusa-embedding-0001 menghasilkan vektor embedding 768 dimensi dengan harga gratis/termasuk dalam kuota Neosantara.